Bu Sayfada 5
Çok turlu otonom coding agentlar, yoğun miktarda token tüketir. Bir agent derleme script’leri çalıştırdığında, test hatalarını incelediğinde ve birden fazla kaynak dosyayı refactor ettiğinde context window kolaylıkla 60.000 token sınırını aşabilir.
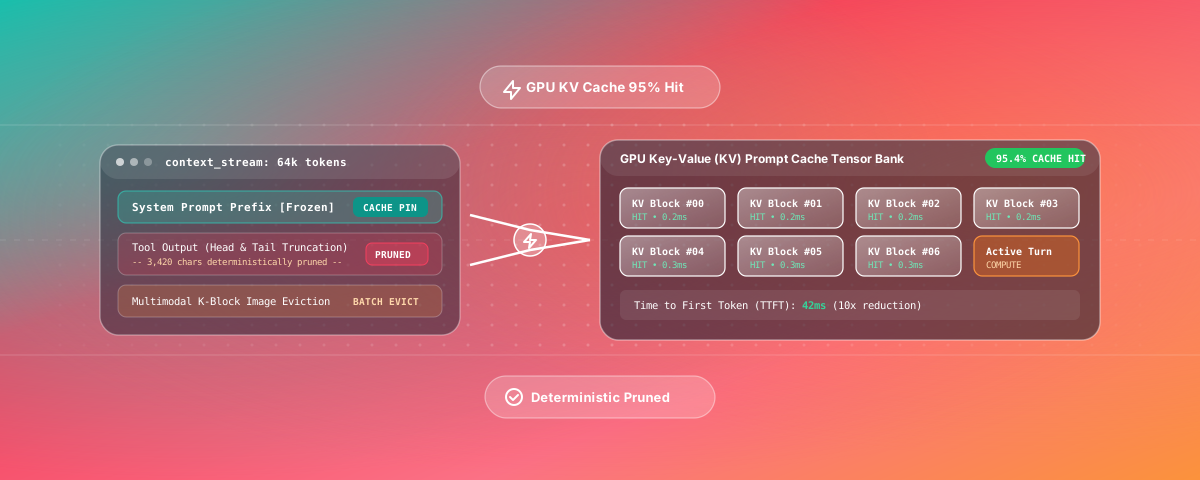
Eğer bir agent motoru keyfi mesajları rastgele kırparsa veya prompt ortasına değişken metadata eklerse, sunucu tarafındaki GPU KV (Key-Value) Prompt Cache hizalamasını bozar. Prompt cache kaçırıldığında (miss) gecikme süresi 5 ila 10 kat artar ve token maliyetleri hızla yükselir.
Bu makalede, SuchTedium içerisindeki context optimizasyonu ve prompt caching mimarisini açıklıyoruz.
İnteraktif Agent Çalıştırma İş Akışı
Context compaction ve akıl yürütme sürecimizin beş aşamasını bu interaktif Archify iş akışı diyagramında adım adım inceleyin:
1. Summarization Öncesi Deterministik Tool Pruning
Çoğu agent framework’ü, context limitleri yaklaştığında doğrudan tam LLM summarization çağrılarına başvurur. Bu yöntem etkili olsa da ciddi bir gecikme süresi yaratır ve sonraki tüm turların ortak token prefix’ini kalıcı olarak bozar.
SuchTedium, öncelikle Deterministik Tool Pruning uygular:
- Uzunluk Tavanı: Uzunluk sınırını aşan her tool çıktısı deterministik olarak budanır.
- Head / Tail Ayrımı: Komut çağrısını ve ilk derleyici başlıklarını, son stack trace ve özet satırlarıyla birlikte korur.
- Marker Formatı: Kırpılan karakter sayısını belirten açık bir işaretçi ekler.
Bu işlemi konuşma geçmişine dokunmadan önce deterministik olarak gerçekleştirerek, ortak prompt prefix’i ardışık iterasyonlar boyunca byte düzeyinde özdeş kalır ve sunucu tarafındaki prompt cache yeniden kullanımını maksimize eder.
2. Multimodal Quantized Image Eviction
Kullanıcılar UI mockup’ları, ekran görüntüleri veya wireframe’ler yüklediğinde multimodal görsel token’lar devasa GPU tensor belleği kaplar. Yeni ekran görüntüleri geldikçe görseller tek tek düşürülürse, görsel token dizisi sürekli yer değiştirir.
Cache warming durumunu korumak için SuchTedium, Quantum Batch Eviction uygular:
- Eviction Quantum: Görseller tek tek değil, sabit kuantum blokları halinde bellekten çıkarılır.
- Tetikleme Eşiği: Toplu çıkarma yalnızca aktif görsel sayısı belirlenen limitleri aştığında devreye girer.
- İlk Context Koruması: İlk turlarda sunulan kullanıcı wireframe’leri ve spesifikasyon mockup’ları sabitlenir ve eviction işleminden korunur.
Tahliyeleri sabit kuantumlara bölerek, KV cache içerisindeki görsel tensor pozisyonları ara iterasyonlar boyunca tamamen statik kalır ve GPU yeniden hesaplamasını ortadan kaldırır.
3. Katı Tool Eşleme Invariant’ları
Acemi agent mimarilerinde sık yapılan hatalardan biri, context penceresini rastgele mesaj indekslerinden dilimlemektir. Modern tool çağıran API’larda, tool_calls içeren bir mesaj her zaman hemen ardından eşleşen tool sonuç mesajı ile takip edilmelidir.
Eğer kayan pencere bir çağrı ile sonucu arasından kesilirse, model sağlayıcı prompt’u geçersiz yapı hatasıyla reddeder. SuchTedium’un compaction algoritmaları, tool çağrı ve yanıt çiftlerini bölünemez atomik birimler olarak ele alır.
Yüksek Performanslı Coding Agentlar Deneyimini Yaşayın
SuchTedium üzerinde milisaniye düzeyinde akıl yürütme yanıtlarını, akıllı context pruning yöntemlerini ve gerçek zamanlı deliverable üretimini deneyimleyin.