Bu Sayfada 14
- Kurumsal token tüketimi nereye gidiyor: 2026 472 şirketlik benchmark
- İş Birimi (BU) + IT ortak sahipliği: neden tek sahip sadece IT olmamalı?
- Foundation Decision Models (“System One”): yalnızca girdi token ücretiyle 35 kat daha hızlı ve 200 kat daha ucuz karar
- Akıllı model routing ve Ekim 2026 OpenRouter benchmark verileri
- Ekim 2026 OpenRouter ve Artificial Analysis Pareto model katmanları
- Inference kapasite katmanları: goodput, PTU ve -%50 Batch API
- Token minimizasyonu ve token maksimizasyonu
- Çıktı tokenları neden girdi tokenlarından 3 ila 5 kat daha pahalıdır?
- Prefix KV cache ve Token Yield Rate denetimi
- Test-time compute ölçekleme ve doygunluk sınırı (N∗N^*N∗)
- AI FinOps yönetişimi, FOCUS 1.4 şeması ve CFO birim ekonomisi
- Dört seviyeli birim ekonomisi hiyerarşisi ve İş Birimi goodput sorumluluğu
- 90 günlük uygulama yol haritası
- Referanslar ve birincil kaynaklar
Kurumsal AI harcamaları 2026’da 1,7 milyar dolardan 37 kat artışla 64 milyar doları aştı [6]; aylık küresel tüketimin ise 2030’a kadar 120 katrilyon tokena ulaşması [6] bekleniyor. Sabit ücretli kullanıcı lisanslarının yerini kullandıkça ödenen token paketleri alınca [5], her AI sorgusunun maliyeti doğrudan şirket gelir tablosuna (P&L) girdi. Bugün şirketlerin %88’i AI kullanıyor, ancak yalnızca %23’ü bunu ölçülebilir kazanca dönüştürebiliyor ve sadece %6’sı faaliyet kârında (EBIT) %5’in üzerinde artış görüyor [7].
Kurumsal token tüketimi nereye gidiyor: 2026 472 şirketlik benchmark
Toplam 4,6 trilyon dolar gelirli 472 büyük şirketi inceleyen Eylül 2026 State of Tokenomics raporu [1], şirketlerin yarısının aynı anda en az dört farklı kanaldan (doğrudan API, bulut gateway, SaaS araçları ve özel sunucular) AI kullandığını gösteriyor. Şirketlerin %53’ü toplam AI faturasını takip edebiliyor, ancak %74’ü bu harcamanın iş getirisini (ROI) CFO’ya kanıtlayamıyor [1].
Frontier bağımlılığı 12 ayda %51’den %24’e düşüyor
Şirketlerin %50’si 4+ kanalı birlikte kullanıyor
İş Birimi (BU) + IT ortak sahipliği: neden tek sahip sadece IT olmamalı?
Kapalı frontier modellere bağımlılık 12 ay içinde %51’den %24’e düşerken [1], şirketlerin %20’si artık prodüksiyonda Qwen3.8 Max, DeepSeek V4.1 Flash veya GLM-5.3 gibi open-weight modelleri kullanıyor. Burada temel kural şudur: token bütçesi tek başına IT’ye bırakılmamalıdır. Fatura yalnızca merkezi IT bütçesinden ödendiğinde, iş birimleri token maliyetini üstlenmez ve goodput (iş sonucuna dönüşen kullanılabilir çıktı) veya hatalı denemeler için sorumluluk almaz [1], [7]. IT’nin teknik altyapıyı yönettiği, İş Birimlerinin (Business Units) ise kendi cost_center bütçesini üstlenip iş çıktısını kanıtladığı ortak modeli kuran şirketler CFO’ya 3,7 kat daha yüksek oranda ROI kanıtlarken, bütçe sahibi belirsiz olan %12’lik grupta bu oran %0’dır [1].
Foundation Decision Models (“System One”): yalnızca girdi token ücretiyle 35 kat daha hızlı ve 200 kat daha ucuz karar
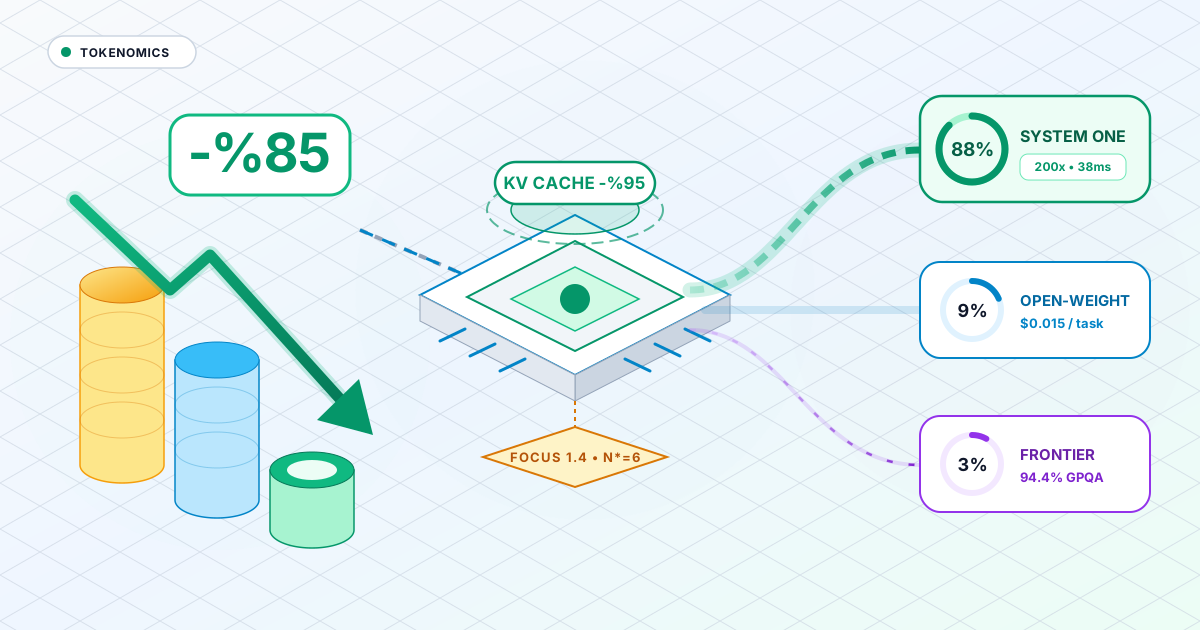
Şirketler uzun süre sınıflandırma ve onay kararları için sohbet odaklı LLM’leri kullandı; yalnızca {"durum": "güvenli"} JSON yanıtını üretmek için saniyelerce bekledi ve girdi maliyetine ek olarak 3 ila 5 kat daha pahalı çıktı token ücreti ödedi [8], [13]. 2026 sonbaharında TypeSafe AI (Jev), Microsoft (Decision-1), Cloudflare (Clef-flash), OpenAI ve AWS (Strands Decider) tarafından sunulan Foundation Decision Models (“System One”) ise metin üretmez: context verisini ve olası şıkları tek geçişte okuyup doğrudan olasılık yüzdeleri döndürür [13]. Bu modeller okudukları girdi (input) tokenları için ücret alır, ancak metin üretmedikleri için çıktı (output) token maliyeti oluşturmaz [13]. İlk kademeye yerleştirilen bir karar modeli, rutin taleplerin %85 ila %90’ını yalnızca girdi token maliyetiyle çözerek toplam AI faturasını %90’ın üzerinde düşürür [13], Workday ve Sana gibi uygulamalarda 100 ms altında arama niyeti tahmin eder ve otonom agents işlem yapmadan önce 40 ila 150 ms içinde güvenlik guardrails kontrolü uygular [13].
%88 Hızlı Şerit (Yalnızca Input)
%12 Eskalasyon
Akıllı model routing ve Ekim 2026 OpenRouter benchmark verileri
2026’da şirketlerin %86’sı model router kullanıyor ve bu sayede CFO’ya ROI kanıtlama olasılığını 4 kat artırıyor [1]. Kurumsal sorguların %60 ila %80’i en büyük frontier modelleri gerektirmediği için [5], RouteLLM ve FrugalGPT gibi router sistemleri frontier kalitesinin %95’ini koruyarak token maliyetini %35 ila %85 düşürüyor [10].
Ekim 2026 OpenRouter ve Artificial Analysis Pareto model katmanları
OpenRouter Benchmark API (/api/v1/benchmarks, 15 Ekim 2026) [2] verileri, model seçerken üç ayrı grafiğe (Görev Başına Maliyet, 1M Girdi Maliyeti ve 1M Çıktı Maliyeti) birlikte bakmak gerektiğini gösteriyor. Örneğin GPT-6.1 Sol, birim token fiyatı yüksek görünse de kısa ve öz yanıt verdiği için %94.4 GPQA Diamond doğruluğunda görev başına $0.0214 [2] maliyetle çalışır. Verimlilik eğrisinin diğer basamaklarını ise Qwen3.8 27B ($0.015/görev), DeepSeek V4.1 Flash ($0.0175/görev), Claude Haiku 5.5 ($0.0195/görev), Muse Spark 1.3 ($0.021/görev), Claude Sonnet 5.5 ($0.0252/görev) ve Claude Opus 5.5 ($0.088/görev) oluşturur [2].
Güncel router araştırmaları (arXiv:2610.02762 [10]), onlarca modeli doğrudan router’a bağlamanın karar kalitesini düşürdüğünü gösteriyor: router prompt uzunluğunu görev zorluğuyla karıştırıyor. Kısa ama zor bir matematik veya coding sorusunu kolay varsayıp zayıf modele gönderirken, uzun ama basit bir e-posta özetini zor varsayıp pahalı frontier modele yönlendiriyor. Bunu önlemek için aktif model listesini üç Pareto katmanıyla sınırlandırın: bir hızlı kompakt model (DeepSeek V4.1 Flash, Claude Haiku 5.5 veya Qwen3.8 27B), bir open-weight genel model (Muse Spark 1.3 veya Qwen3.8 Max) ve bir üst düzey frontier model (Claude Sonnet 5.5 veya Claude Opus 5.5).
Inference kapasite katmanları: goodput, PTU ve -%50 Batch API
Ham throughput, GPU sunucusunun saniyede ürettiği tüm tokenları sayar; ancak yoğunluk arttığında geç gelen yanıtlar pratikte kullanılamaz [4], [8]. Bu nedenle kurumsal sistemlerde goodput ölçülür: kalite hedefini sağlayan, ilk kelimesi zamanında gelen (TTFT, Time to First Token) ve okuma hızında kesintisiz akan (TPS, Tokens Per Second) kullanılabilir çıktı [4]. Donanım tarafında ise NVIDIA Hopper H100’den Blackwell B200/GB200 sunuculara geçiş milyon token başına üretim maliyetini 25 kata kadar düşürürken megavat başına throughput kapasitesini 25 kat artırır [4].
Canlı müşteri trafiğinde (< 0.5s) gereksiz GPU satın almadan HTTP 429 hız sınırı (rate-limit) hatalarını önlemek için şirketler, sabit taban yükünü Provisioned Throughput Units (PTU / GSU) ile rezerve eder; ani yoğunlukları ise Direct API, AWS Bedrock ve Vertex AI üzerindeki Priority / kullandıkça öde (PAYG) katmanına aktarır [3], [4]. Günlük sohbet ve RAG sorguları Goldilocks bölgesinde (1-2s yanıt süresi ve -%90 KV cache indirimi) çalışır. Acil olmayan işleri Flex Processing (5-60s) veya Async Batch API (< 24h) kuyruğuna göndermek ise token fiyatını doğrudan %50 indirir ve ayrı bir kota havuzu kullandığı için canlı kullanıcı trafiğini yavaşlatmaz [3], [8].
Token minimizasyonu ve token maksimizasyonu
Her kurumsal agent iş akışının toplam token tüketimi beş parçadan oluşur [9]:
Burada normal girdi tokenlarını, cache’ten indirimli okunan girdiyi, modelin arka planda düşünürken (reasoning) harcadığı tokenları, kullanıcıya görünen çıktıyı ve birden fazla agent’ın birbiriyle haberleşirken tükettiği tokenları gösterir [9].
Çıktı tokenları neden girdi tokenlarından 3 ila 5 kat daha pahalıdır?
Model sağlayıcıları çıktı tokenlarını girdi tokenlarından 3 ila 5 kat daha pahalıya satar [2] (Claude Sonnet 5.5 için $2.00 girdi / $10.00 çıktı; Claude Opus 5.5 için $4.40 / $22.00). Nedeni donanım çalışma şeklidir: GPU girdi metnini tek seferde paralel okurken, çıktıdaki her kelimeyi tek tek üretir ve her kelimede model ağırlıklarını GPU belleğinden yeniden okur [4], [8].
Prefix KV cache ve Token Yield Rate denetimi
Her sorguda tekrar gönderilen sabit sistem promptlarını ve araç (tool) tanımlarını GPU KV cache belleğinde tutmak, girdi okuma maliyetini %90 ila %95 düşürür [2]. Bu sayede 6.600 tokenlık araç tanımı içeren 1 milyon çağrının faturası $13.200’dan $660’a iner. Ekipler ayrıca hatalı denemelere, yarım kalan oturumlara ve kalite kontrolünden dönen yanıtlara giden payı ölçmek için Token Yield Rate (Faydalı Token Oranı) metriğini takip eder [6], [9]:
Test-time compute ölçekleme ve doygunluk sınırı ()
Yazılım mimarisi veya finansal modelleme gibi zor görevlerde reasoning modelleri (Claude Opus 5.5, Gemini 4 Argon, GPT-6.1 Sol), daha doğru sonuç bulmak için arka planda ek düşünme tokenı () harcar. Ancak her yeni düşünme adımının sağladığı doğruluk artışı formülüyle hızla sıfıra yaklaşır [9], [11]. Bu nedenle prodüksiyon sistemlerinde, ek düşünme adımlarının doğruluğu artırmadığı doygunluk noktası üzerinde döngüyü durduran bir sınır (circuit breaker) bulunmalıdır [9], [12]:
Marjinal kazanç < ε olduğunda otonom döngüyü keser
AI FinOps yönetişimi, FOCUS 1.4 şeması ve CFO birim ekonomisi
Farklı bulut, API ve SaaS faturalarını tek bir standartta birleştirmek için finans ekipleri, girdi (x_InputTokens) ve çıktı (x_OutputTokens) maliyetlerini ayrı ayrı gösteren FinOps FOCUS 1.4 (Haziran 2026) [3] standardını kullanıyor:
Her gateway çağrısına trace_id, cost_center ve task_intent etiketleri eklemek, token maliyetini merkezi IT bütçesi yerine doğrudan ilgili İş Biriminin (Business Unit) P&L bütçesine yansıtır [1], [3].
Dört seviyeli birim ekonomisi hiyerarşisi ve İş Birimi goodput sorumluluğu
IT ve Platform Mühendisliği 1. ve 2. seviyeleri (milyon token başına birim fiyatı düşürmek ve KV cache oranını artırmak) yönetirken, İş Birimleri (LoB Başkan Yardımcıları ve Ürün Sahipleri) departman token bütçesini taşır ve 3. seviye goodput çıktısını kanıtlamaktan sorumludur [1], [7]. Örneğin bir Uyumluluk İş Birimi, 80 saatlik analist mesaisini ($6.000 işçilik) 2 saatlik uzman kontrolü ($150) ve $200 goodput token maliyetiyle ($350 toplam) tamamladığında, CFO’ya döngü başına $5.650 net P&L tasarrufu (%94 maliyet düşüşü) kanıtlar [7].
cost_center bütçesini taşır ve çıktıyı kanıtlar90 günlük uygulama yol haritası
- 1 ila 30. Günler (Gözlemlenebilirlik, FOCUS 1.4 ve İş Birimi Chargeback): Tüm AI trafiğini
trace_idvecost_centeretiketleyen merkezi bir gateway üzerinden geçirin, faturaları FOCUS 1.4 [3] şemasıyla toplayın ve token bütçesini tek başına IT’de tutmak yerine her İş Biriminin kendi goodput çıktısını kanıtladığı ortak sahiplik modeline geçirin [1]. - 31 ila 60. Günler (Decision Models, 3 Katmanlı Pareto Routing ve KV Cache): İlk kademeye bir System One karar modeli (
TypeSafe Jev/Decision-1/Clef-flash) yerleştirin [13], aktif LLM listesini üç Pareto katmanına (DeepSeek V4.1 Flash/Claude Haiku 5.5,Muse Spark 1.3/Qwen3.8 MaxveClaude Sonnet 5.5/Opus 5.5) indirin [2], [10], %95 KV cache indirimini sabitleyin ve döngüleri sınırında durdurun [9]. - 61 ila 90. Günler (İş Birimi Goodput Denetimi ve Bütçe Kaydırma): Aylık CFO toplantılarında her İş Biriminin Seviye 3 metriklerini (Doğrulanmış Çıktı Başına Maliyet ve Token Yield Rate) raporlamasını zorunlu kılın [6] ve düşük goodput üreten akışların bütçesini yüksek getirili birimlere aktarın [7].
Referanslar ve birincil kaynaklar
- Linux Foundation / FinOps Foundation: State of Tokenomics Report across 472 Enterprises (Eylül 2026) · [Arşiv]
- OpenRouter Unified Benchmark API (
/api/v1/benchmarks: Artificial Analysis, GPQA Diamond & Tau-Bench, Ekim 2026) · [Arşiv] - FinOps Foundation: Token Economics and the FOCUS 1.4 Specification (Haziran 2026) · [Arşiv]
- NVIDIA AI: Enterprise Tokenomics Guide & Blackwell B200/GB200 Inference Economics · [Arşiv]
- Accenture: AI Tokenomics for Enterprise Value and C-Suite Governance · [Arşiv]
- Capgemini: The AI Compass Issue 1, AI Yield (Ekim 2026) · [Arşiv]
- Deloitte: A CFO’s Guide to Governing the AI P&L · [Arşiv]
- arXiv:2606.24616: AI Tokenomics: The Economics of Tokens, Computation, and Pricing (Haziran 2026) · [Arşiv]
- arXiv:2605.09104: Token Economics for LLM Agents: A Dual-View Study (Mayıs 2026) · [Arşiv]
- arXiv:2610.02762: Dynamic LLM Routers are Often Misguided (Ekim 2026) · [Arşiv]
- arXiv:2604.10739: When More Thinking Hurts: Overthinking in LLM Test-Time Compute (Nisan 2026) · [Arşiv]
- ICLR 2026: Zero-Overhead Introspection for Adaptive Test-Time Compute · [Arşiv]
- Foundation Decision Models (“System One”): TypeSafe AI Jev, Microsoft Decision-1, Cloudflare Clef-flash & AWS Strands Decider Benchmarks (Sonbahar 2026) · [Arşiv]